
一句话:用 Kaggle 免费送的两张 T4 显卡,跑起 Qwen3.8-27B(abliterated 版,Q6_K 量化),再通过一条加密隧道把它变成一个带密钥、兼容 OpenAI 格式的 API。从点开 Kaggle 到能问答,全程约 12 分钟,花费 0 元。
实测时间:2026 年 11 月 16 日(北京时间)。
一、先搞懂几个概念(30 秒版)
| 名词 | 通俗解释 |
|---|---|
| Kaggle | 谷歌旗下的数据科学平台,注册并验证手机号后,每周免费送约 30 小时 GPU。 |
| T4 ×2 | 两张英伟达 T4 显卡,每张约 15–16GB 显存,合计约 30GB。注意是"两张小卡",不是"一张大卡"。 |
| 27B | 模型有 270 亿个参数。参数越多一般越聪明,也越吃显存。 |
| 量化(Quantization) | 把模型参数从 16 位"压缩"成更少的位数。好比把无损音乐转成高码率 MP3:体积小很多,听感几乎不变。 |
| Q6_K | 6 位量化,质量接近原版。27B 模型在这个精度下约 22.4GB。 |
| Ollama | 一个"一键跑大模型"的工具,自带 OpenAI 兼容接口。 |
| Cloudflare 快速隧道 | 把 Kaggle 机器里的本地服务临时映射成一个公网 https 地址,不用开端口、不用服务器。 |
| abliterated | 社区用"消融"技术去掉了模型拒答倾向的版本(来自 Hugging Face 上的 huihui-ai)。 |
二、为什么选 Q6_K?
模型仓库 huihui-ai/Huihui-Qwen3.8-27B-abliterated-GGUF 里有几十个量化文件,挑几个关键的:
| 量化 | 文件大小 | 能否放进 2×T4 | 评价 |
|---|---|---|---|
| Q4_K | 16.8 GB | 轻松 | 速度快,质量有可见损失 |
| Q5_K | 19.5 GB | 可以 | 均衡 |
| Q6_K | 22.4 GB | 可以(还剩约 7GB 给上下文) | 接近无损,本次选择 |
| Q8_0 | 29.1 GB | 太挤,基本放不下 | 两张卡加起来才约 30GB |
结论:在免费硬件上能跑的"最好的量化"就是 Q6_K,上下文设为 8K,并开启 Flash Attention 和 8 位 KV 缓存来省显存。
三、整体架构
你的电脑 / 手机
     │  HTTPS + Bearer 密钥
     ▼
Cloudflare 快速隧道(xxxx.trycloudflare.com)
     │
     ▼
Kaggle 笔记本(GPU T4 ×2)
  ├─ 鉴权代理 :8080   ← 没带正确密钥一律返回 401
  └─ Ollama   :11434 ← 加载 Qwen3.8-27B Q6_K,分摊到两张 T4
为什么要加"鉴权代理"?因为快速隧道地址是公开的,谁拿到地址都能用。Ollama 自己不支持 API Key,所以在前面加一层只有几十行的 Python 代理,校验 Authorization: Bearer <密钥>。
四、操作步骤
第 1 步:准备 Kaggle 账号
- 注册 Kaggle(邮箱注册即可)。
- 进入 Settings → Phone verification 完成手机验证。不验证就用不了 GPU 和联网。

第 2 步:新建笔记本并打开 GPU 和网络
- 点 Create → New Notebook,标题随意(本文叫
qwen-api),保持 Private。 - 右侧 Settings → Accelerator 选 GPU T4 x2。
- 确认 Internet 为开启状态。
第 3 步:写入部署脚本
笔记本里只放一个代码单元。完整脚本如下(把密钥和通知频道换成你自己的,密钥可以用 python -c "import secrets;print('sk-'+secrets.token_hex(16))" 生成):
# Kaggle T4x2: serve Huihui-Qwen3.8-27B-abliterated Q6_K via Ollama behind an API-key proxy + Cloudflare quick tunnel.
import os, subprocess, time, re, threading, json, urllib.request, sys

API_KEY = "sk-你自己生成的密钥"
NTFY = "https://ntfy.sh/你自己的随机频道名"
LIFETIME_H = float(os.environ.get("LIFETIME_H", "3"))
REPO = "huihui-ai/Huihui-Qwen3.8-27B-abliterated-GGUF"
FILE = "Huihui-Qwen3.8-27B-abliterated-Q6_K.gguf"
MODEL = "qwen3.8-27b-abliterated"
WORK = "/kaggle/temp"
os.makedirs(WORK, exist_ok=True)

def say(msg):
    print(msg, flush=True)
    try:
        urllib.request.urlopen(urllib.request.Request(NTFY, data=msg.encode()), timeout=10)
    except Exception as e:
        print("ntfy fail", e, flush=True)

def sh(cmd):
    print("$", cmd, flush=True)
    subprocess.run(cmd, shell=True, check=True)

say("STAGE start")
sh("nvidia-smi -L")
sh("apt-get install -y zstd >/dev/null 2>&1 || true")
sh("curl -fsSL https://ollama.com/install.sh | sh >/dev/null 2>&1")
sh(f"curl -fsSL -o {WORK}/cloudflared https://github.com/cloudflare/cloudflared/releases/latest/download/cloudflared-linux-amd64 && chmod +x {WORK}/cloudflared")
say("STAGE installed")

env = {**os.environ, "OLLAMA_MODELS": f"{WORK}/ollama", "OLLAMA_HOST": "127.0.0.1:11434",
       "OLLAMA_CONTEXT_LENGTH": "8192", "OLLAMA_KEEP_ALIVE": "-1",
       "OLLAMA_FLASH_ATTENTION": "1", "OLLAMA_KV_CACHE_TYPE": "q8_0"}
ollama = subprocess.Popen(["ollama", "serve"], env=env, stdout=open(f"{WORK}/ollama.log", "w"), stderr=subprocess.STDOUT)
time.sleep(8)

# download GGUF directly (exact file), then register with Ollama
gguf = f"{WORK}/{FILE}"
if not os.path.exists(gguf):
    sh(f"curl -L --fail --retry 5 -s -o {gguf} https://huggingface.co/{REPO}/resolve/main/{FILE}")
say("STAGE downloaded")
open(f"{WORK}/Modelfile", "w").write(f"FROM {gguf}\nPARAMETER num_ctx 8192\n")
subprocess.run(["ollama", "create", MODEL, "-f", f"{WORK}/Modelfile"], env=env, check=True)

# warm up
req = urllib.request.Request("http://127.0.0.1:11434/api/generate",
      data=json.dumps({"model": MODEL, "prompt": "hi", "stream": False, "options": {"num_predict": 8}}).encode(),
      headers={"Content-Type": "application/json"})
t = time.time(); urllib.request.urlopen(req, timeout=900).read()
say(f"STAGE model_loaded {int(time.time()-t)}s")
subprocess.run("ollama ps; nvidia-smi --query-gpu=memory.used,memory.total --format=csv", shell=True, env=env)

# API-key proxy on 8080 -> ollama 11434 (supports streaming)
from http.server import ThreadingHTTPServer, BaseHTTPRequestHandler
import http.client
class P(BaseHTTPRequestHandler):
    protocol_version = "HTTP/1.1"
    def log_message(self, *a): pass
    def _go(self):
        auth = self.headers.get("Authorization", "")
        if auth != f"Bearer {API_KEY}":
            b = b'{"error":"unauthorized"}'
            self.send_response(401); self.send_header("Content-Type","application/json"); self.send_header("Content-Length",str(len(b))); self.end_headers(); self.wfile.write(b); return
        n = int(self.headers.get("Content-Length") or 0)
        body = self.rfile.read(n) if n else None
        c = http.client.HTTPConnection("127.0.0.1", 11434, timeout=1800)
        h = {k: v for k, v in self.headers.items() if k.lower() not in ("host", "authorization", "content-length")}
        c.request(self.command, self.path, body=body, headers=h)
        r = c.getresponse()
        self.send_response(r.status)
        for k, v in r.getheaders():
            if k.lower() not in ("transfer-encoding", "content-length", "connection"):
                self.send_header(k, v)
        self.send_header("Transfer-Encoding", "chunked"); self.end_headers()
        while True:
            chunk = r.read1(65536) if hasattr(r, "read1") else r.read(65536)
            if not chunk: break
            self.wfile.write(b"%x\r\n%s\r\n" % (len(chunk), chunk)); self.wfile.flush()
        self.wfile.write(b"0\r\n\r\n"); self.wfile.flush()
    do_GET = do_POST = _go
srv = ThreadingHTTPServer(("127.0.0.1", 8080), P)
threading.Thread(target=srv.serve_forever, daemon=True).start()

cf = subprocess.Popen([f"{WORK}/cloudflared", "tunnel", "--no-autoupdate", "--url", "http://127.0.0.1:8080"],
                      stdout=subprocess.PIPE, stderr=subprocess.STDOUT, text=True)
url = None
for line in cf.stdout:
    m = re.search(r"https://[a-z0-9-]+\.trycloudflare\.com", line)
    if m: url = m.group(0); break
threading.Thread(target=lambda: [None for _ in cf.stdout], daemon=True).start()
time.sleep(5)
say(f"READY {url} model={MODEL} lifetime_h={LIFETIME_H}")

end = time.time() + LIFETIME_H * 3600
while time.time() < end:
    time.sleep(60)
    if cf.poll() is not None or ollama.poll() is not None:
        say("STAGE died"); break
say("STAGE stopped")
脚本做了这几件事:
- 安装 Ollama 和 cloudflared;
- 从 Hugging Face 直接下载 Q6_K 的 GGUF 文件(约 22.4GB,存到
/kaggle/temp,因为/kaggle/working只有 20GB); - 用 Modelfile 注册模型,预热加载到两张显卡;
- 启动带密钥校验的代理;
- 开隧道,拿到公网地址,并推送到 ntfy 频道(这样不用盯着日志也能拿到地址);
- 运行 3 小时后自动退出,省 GPU 配额。
小技巧:如果不想把长脚本粘进单元格,可以把脚本放在任意可公开下载的地址,单元格里只写两行:
import subprocess; subprocess.run("curl -fsSL <脚本地址> -o /kaggle/working/run.py", shell=True, check=True)
exec(open('/kaggle/working/run.py').read())
第 4 步:用"后台运行"启动
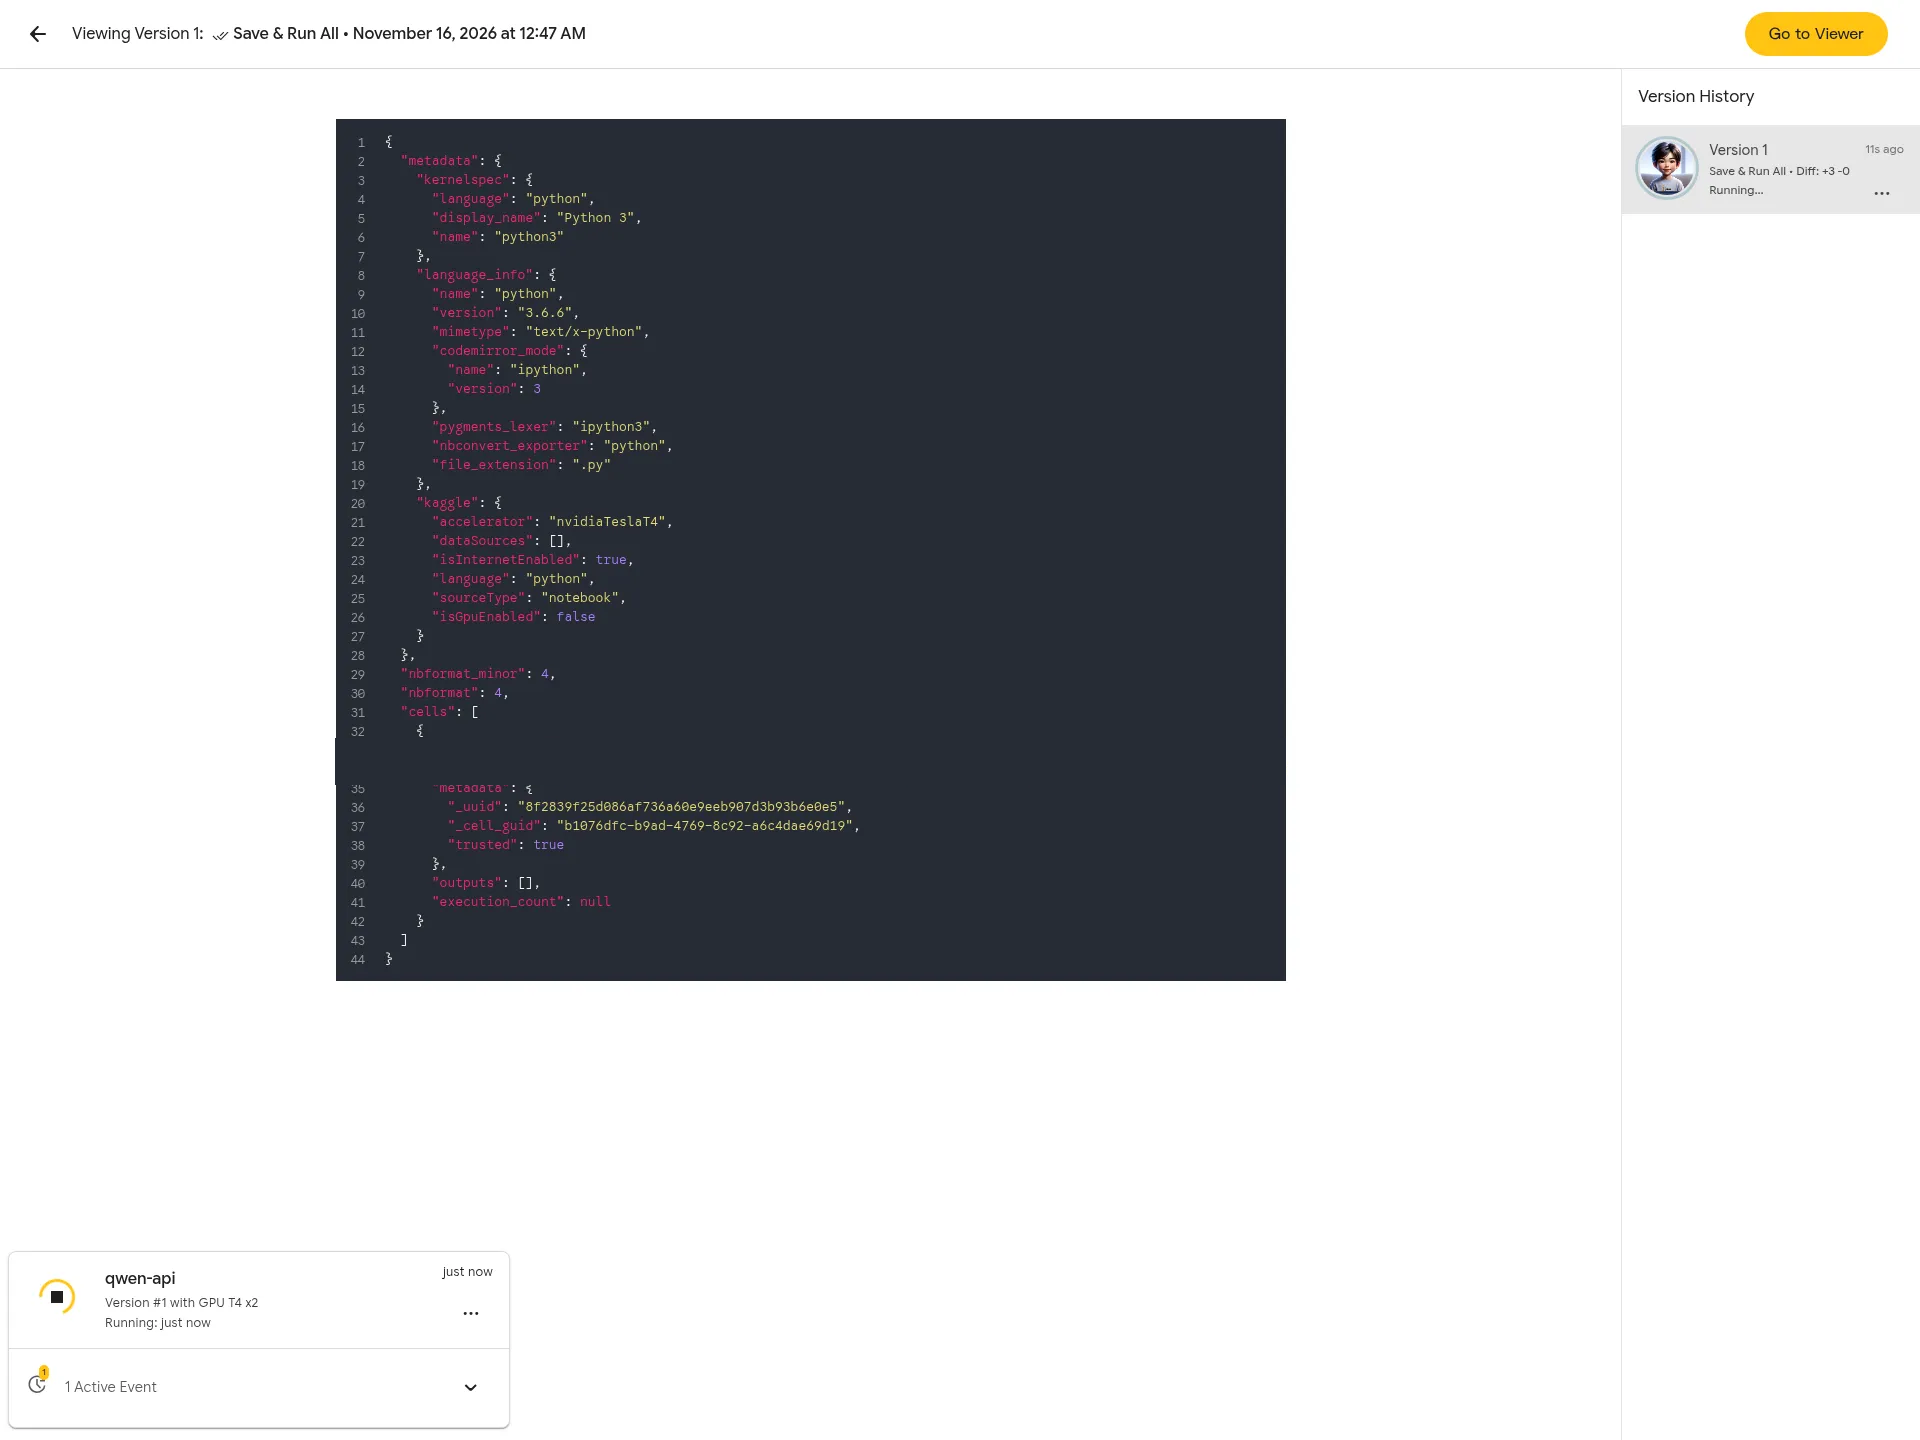
点 Save Version → Save & Run All (Commit)。这样它在后台跑,关掉浏览器也不会因为"空闲超时"被掐掉(交互模式空闲 20–60 分钟会自动断)。
第 5 步:等地址出来
订阅你的 ntfy 频道(手机装 ntfy App,或者浏览器打开 https://ntfy.sh/你的频道名),会依次收到:
| 北京时间 | 阶段 | 说明 |
|---|---|---|
| 00:47:42 | STAGE start | 脚本开始 |
| 00:48:58 | STAGE installed | Ollama、cloudflared 装好(约 1 分钟) |
| 00:51:43 | STAGE downloaded | 22.4GB 模型下完(不到 3 分钟,Kaggle 带宽很猛) |
| 00:59:37 | STAGE model_loaded 188s | 注册 + 加载进显卡,首次加载 188 秒 |
| 00:59:46 | READY https://xxxx.trycloudflare.com | 可以调用了 |
从启动到可用,一共约 12 分钟。
五、验证:真的部署成功了吗?
我做了四项检查。
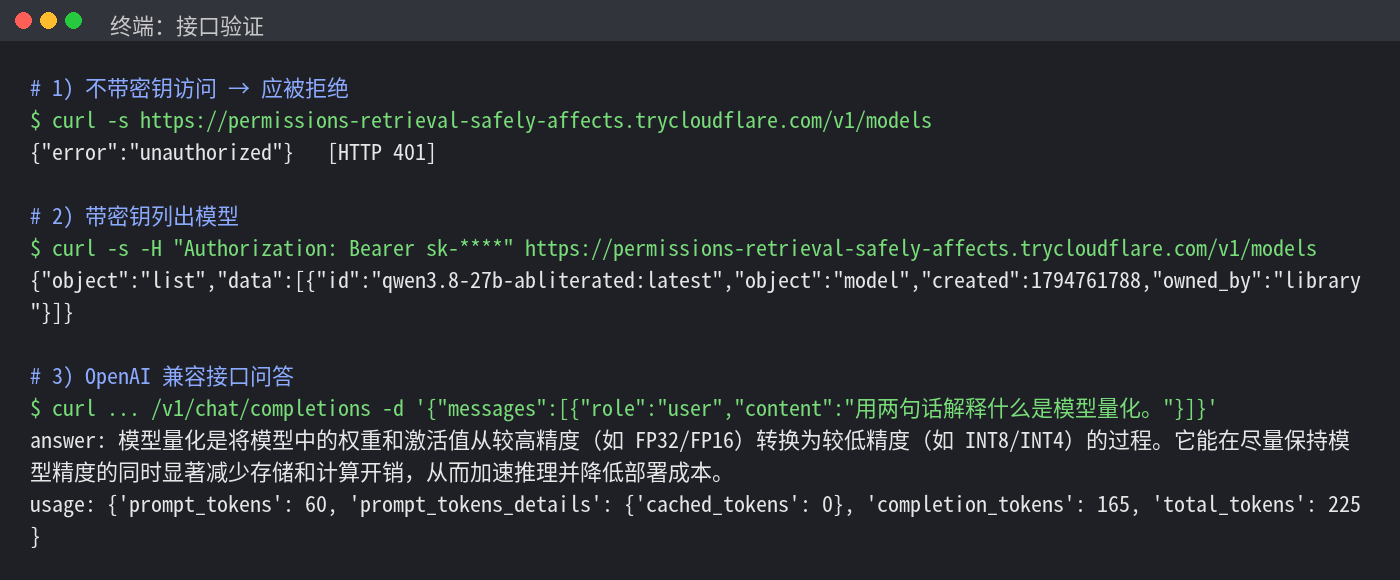
① 鉴权是否生效:不带密钥访问,返回 401 unauthorized。✅
② 模型是否在线:带密钥请求 /v1/models,返回 qwen3.8-27b-abliterated:latest。✅
③ OpenAI 兼容问答:问"用两句话解释什么是模型量化",回答准确、正好两句,并且返回了 reasoning(思考过程)字段。✅
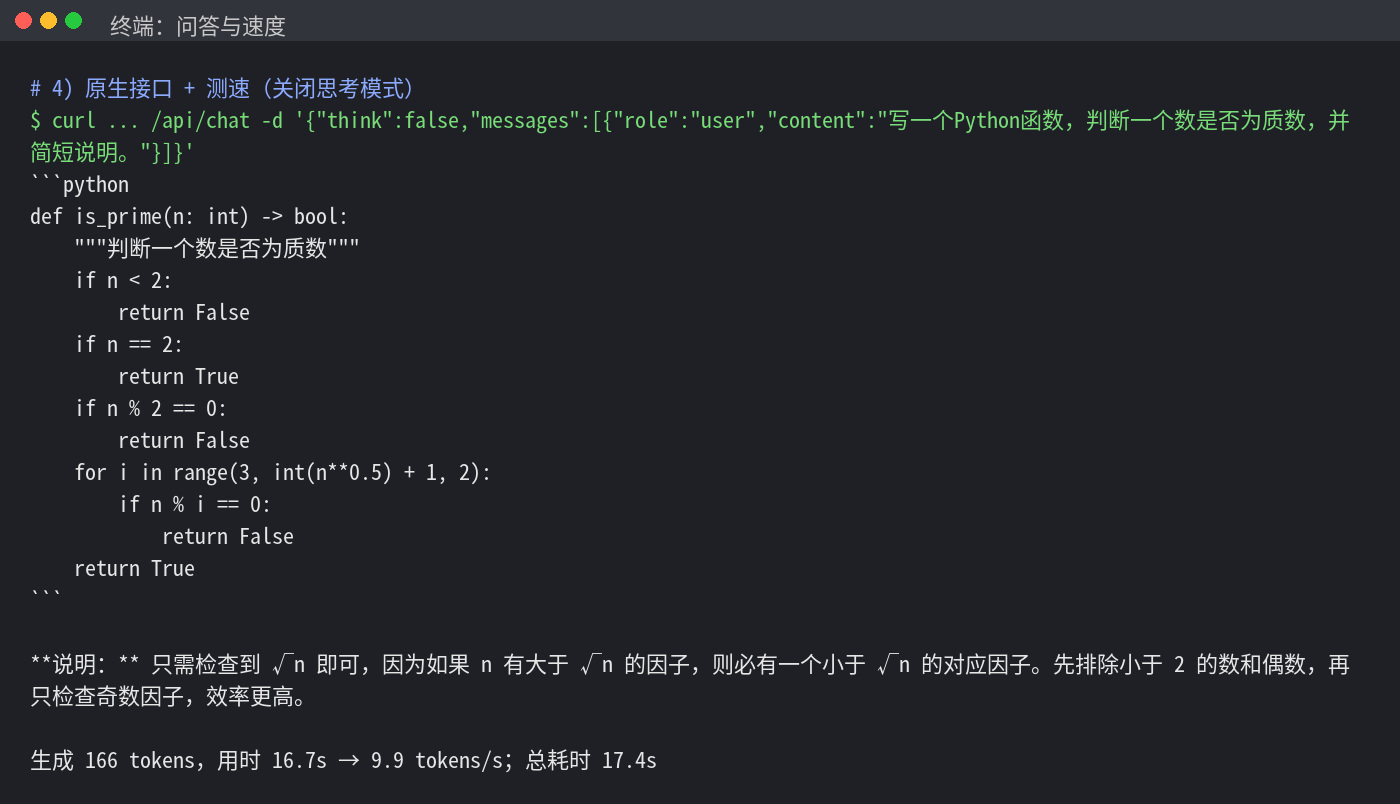
④ 写代码 + 测速:关闭思考模式,让它写判断质数的函数。代码正确,生成 166 个 token 用时 16.7 秒,约 9.9 tokens/秒;读取提示词约 49 tokens/秒。✅
另外测试了流式输出("stream": true),能正常逐字返回。✅
六、怎么调用
curl:
curl https://你的地址.trycloudflare.com/v1/chat/completions \
  -H "Authorization: Bearer sk-你的密钥" \
  -H "Content-Type: application/json" \
  -d '{"model":"qwen3.8-27b-abliterated","messages":[{"role":"user","content":"你好"}]}'
Python(OpenAI SDK):
from openai import OpenAI

client = OpenAI(
    base_url="https://你的地址.trycloudflare.com/v1",
    api_key="sk-你的密钥",
)
resp = client.chat.completions.create(
    model="qwen3.8-27b-abliterated",
    messages=[{"role": "user", "content": "用一句话介绍你自己"}],
)
print(resp.choices[0].message.content)想要更快、不要思考过程:用原生接口 /api/chat,加 "think": false。
接入聊天客户端(Chatbox、Cherry Studio、LobeChat 等):选"OpenAI 兼容",填上面的 base_url 和密钥即可。
七、性能与成本小结
| 项目 | 数值 |
|---|---|
| 硬件 | Kaggle 免费 GPU T4 ×2,4 核 CPU,29GB 内存 |
| 模型 | Huihui-Qwen3.8-27B-abliterated,Q6_K(22.4GB) |
| 上下文 | 8K |
| 部署耗时 | 约 12 分钟 |
| 生成速度 | 约 9.9 tokens/秒(Q6_K) |
| 费用 | 0 元(消耗每周 30 小时 GPU 配额中的一部分) |
速度对比:网上用 Q4 量化在同样硬件上测到约 13 tokens/秒。Q6 更准但稍慢,属于正常取舍。
八、注意事项(一定要看)
- 地址是临时的:每次重启都会换一个新的
trycloudflare.com地址;单次会话最长 12 小时,本脚本 3 小时自动停。 - 配额:GPU 每周约 30 小时,T4×2 跑 1 小时扣 1 小时。用完记得停。
- 平台规则:Kaggle 的可接受使用政策把"server farming(当服务器农场用)"和"生成有害内容"列为滥用。短时间测试模型问题不大;长期当免费 API 用有封号风险。
- 隐私:模型跑在别人的机器上,不要发敏感数据;密钥别泄露。
- 快速隧道:Cloudflare 官方定位是测试用途,不保证稳定。
九、常见问题
- Q8 能不能跑? 29GB 的文件放进约 30GB 显存,几乎没有余量给上下文,大概率爆显存。
- 想要更快? 换 Q4_K(16.8GB),或者换 MoE 结构的 Qwen3.6-35B-A3B(每次只激活 3B 参数)。
- 能跑 70B 吗? 不能,4 位量化也要 40GB 左右。
- 为什么不用 TPU? Kaggle 的 TPU v3-8 有 128GB,但不支持 GGUF/Ollama 这套,需要 JAX 等专门方案,门槛高很多。
全文实测数据均来自 2026-11-16 当次部署。
评论 (0)